AIホームラボで動画自動生成パイプラインを作っています。
目標はシンプルです。
note記事
↓
AIで台本化
↓
Irodori TTSで音声化
↓
Whisperで字幕化
↓
ComfyUIで画像生成
↓
FFmpegで動画化
↓
MP4完成
前回までに、固定テキストから動画を作るところまでは成功しました。
固定テキスト
↓
Irodori
↓
Whisper
↓
ComfyUI
↓
Video API
↓
MP4
固定テキストではなく、生成された音声・字幕・画像のパスをn8n内で受け渡し、最後にAndroidで再生できるMP4まで完成しています。
土台はできました。
次はQwenをつなぐ
次の目標は、固定テキストをやめてローカルLLMで台本を作ることでした。
最初はOllama上の qwen3:4b を使う予定でした。
しかし、これが動きません。
API自体は生きています。
Ollamaも正常。
モデルも認識しています。
それでも日本語を入力するとCPU推論のまま返答が返ってこない。
そこで予定を変更し、
ollama pull qwen2.5:1.5b
を導入しました。
こちらは問題なく動作。
n8nからHTTP Requestで呼び出すと、ちゃんと返答が返ってきます。
つまり、
n8n
↓
Ollama
↓
Qwen
までは成功しました。
note記事をそのまま渡すと汚すぎる
次に実際のnote記事を入力してみました。
ところが、そのままコピーすると、
メニュー
見出し画像
プロフィール
ハッシュタグ
関連記事
有料部分
フォロー誘導
など、本来不要な情報まで大量に混ざります。
当然、このままでは要約精度が落ちます。
そこでQwenの前にCodeノードを追加しました。
やったことは、
「【今回のテーマ】」から本文開始
シリーズ説明削除
免責事項削除
「次回は」以降削除
「ここから先は」以降削除
URL削除
Markdown除去
note特有の装飾除去
です。
これでQwenに渡す文章はかなりきれいになりました。
つまり、
note記事
↓
Codeで本文抽出
↓
Qwen
までは期待通りに動いています。
ローカルLLMは動いた。でも動画台本は作れなかった
ここで壁にぶつかりました。
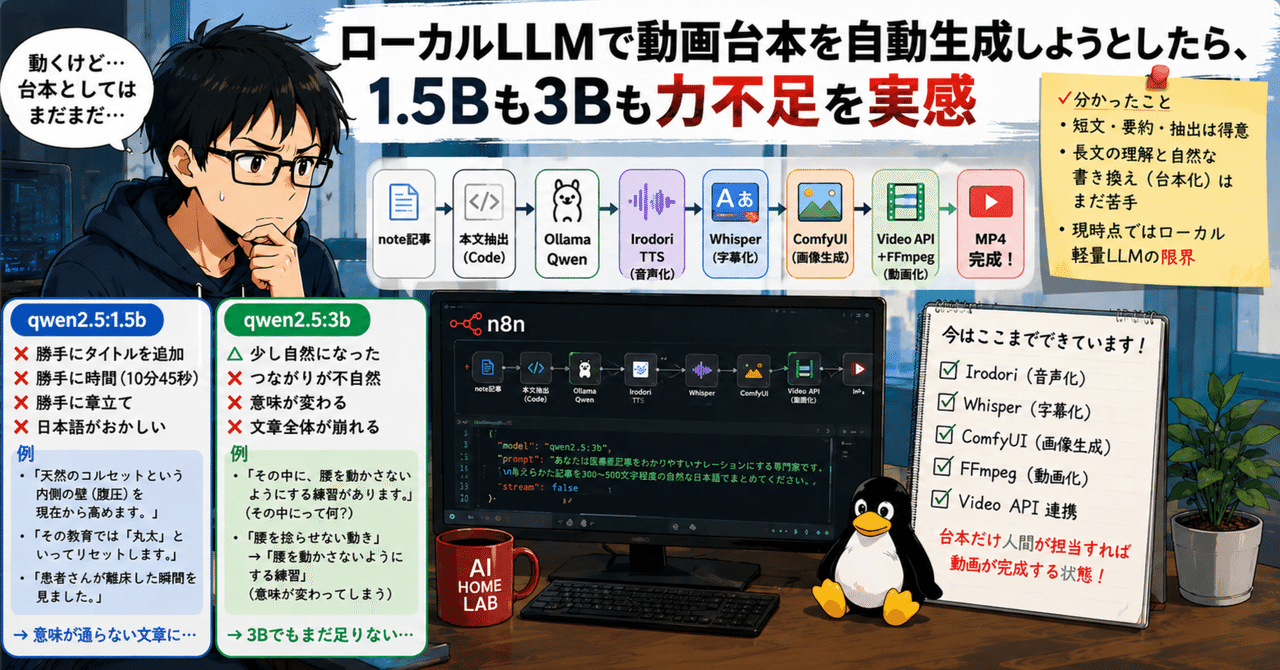
qwen2.5:1.5bは確かに動きます。
しかし、実際のnote記事を300〜500文字程度の動画ナレーションへ変換させると、返ってきた文章は想像とはまったく違いました。
例えば、
【タイトルなし】
【10分45秒】
記事にはタイトルも時間も書いていません。
それなのに、
勝手にタイトルを作る
勝手に動画時間を書く
勝手に章立てする
という、存在しない情報をどんどん追加していきます。
さらに問題だったのは日本語です。
例えば、
「天然のコルセットという内側の壁(腹圧)を現在から高めます。」
これは「少し日本語が不自然」というレベルではありません。
意味そのものが通っておらず、専門用語を理解せずに単語だけを並べたような文章になっていました。
他にも、
「その教育では『丸太』といってリセットします。」
「まずはじめに、脊椎圧迫骨折の患者さんが離床した瞬間を見ました。」
など、記事の内容を理解しているとは思えない文章が続きました。
専門用語も一般用語も崩れ、文章として意味が成立していない部分が目立ちます。
理学療法士が読めばもちろん、一般の人が読んでも「何を言いたいのか分からない」と感じる内容でした。
つまり、
要約が下手だったのではありません。
記事そのものを理解し、それを自然な日本語へ書き換えることが、このモデルには難しかったという印象です。
それでも諦めきれず、3Bモデルも試した
「1.5Bでは小さすぎたのかもしれない。」
そう考え、次にqwen2.5:3bも試してみました。
モデルサイズは約2倍になります。
実際、短い文章では改善も見られました。
しかし、記事全体を動画台本へ変換させると、
「その中に、腰を動かさないようにする練習があります。」
のような文章が返ってきました。
読んだ瞬間、
「その中にって何?」
となります。
さらに、
「腰を捻らせない動き」
が、
「腰を動かさないようにする練習」
へ変わってしまうなど、医療記事では意味が変わってしまう表現も見られました。
1.5Bより改善はしたものの、
「専門記事を理解し、自然な日本語で動画ナレーションへ書き換える」
という用途には、3Bでもまだ力不足という結論になりました。
そういえばClaude APIがあった
そこで、ふと思い出したことがありました。
n8nを導入した頃、「1年間利用できて、Fableモデルも試せる」というキャンペーンで、Claude APIのクレジットを約3,000円分購入していたのです。
当時は「そのうち使うかもしれない」くらいの気持ちでした。
しかし、ローカルLLMで試行錯誤を重ねた今なら、この用途こそClaudeを使うべきなのではないかと思いました。
実際に料金を調べてみると、今回のような動画台本生成であれば、1本あたり数円程度で収まる計算です。
ローカルLLMに無理をさせるより、得意な部分はClaudeに任せた方が、品質も作業効率も大きく向上しそうです。
Claudeも比較してみた
まず試したのは、軽量で低コストなClaude Haikuです。
こちらはQwenとは違い、記事の内容をきちんと理解し、存在しない情報を勝手に追加することもほとんどありませんでした。
YouTube向けの話し言葉としても十分実用レベルです。
ただ、細かく見ると、
「ここはもう少し自然に言えそう」
「少し説明調かな」
と感じる部分もところどころ残りました。
実際に動画として使うなら問題ないものの、「あと一歩」という印象です。
そこで、さらにClaude Sonnetでも試してみました。
結果は、もう一段上でした。
例えば冒頭だけでも、
「以前、私が担当した圧迫骨折の患者さんのことです。コルセットがようやく完成し、いざ離床というその瞬間、私は愕然としました。」
というように、そのまま読み上げられる自然な文章になっていました。
また、
「コルセットという外の壁があっても、動き方が受傷前のままでは脊椎は守れません。」
と、記事の意図を崩さずに表現できています。
さらに、
「肩が早いですよ、もっと腰と一緒に」
「膝が先走っています、もっと全体でゴロンと」
といった記事内の実際の声掛けも自然に残されていました。
Haikuでも十分使えそうですが、細かい日本語の自然さや文章全体の流れは、Sonnetの方が一段上という印象です。
もちろん、その分コストは少し上がります。
それでも動画の入口になる台本であれば、この差には十分価値があると感じました。
今の結論
現時点では、私の環境では次の構成が最もしっくりきています。
note記事
↓
Codeノード(本文抽出・不要部分削除)
↓
Claude Sonnet(動画台本)
↓
Irodori TTS
↓
Whisper
↓
ComfyUI
↓
Video API(FFmpeg)
↓
MP4完成
頓挫ではなく、一つの知見だった
正直、この結果には少しがっかりしました。
「この程度の台本生成ならできるだろう。」
そう思っていました。
でも実際に試してみると違いました。
だからこそ分かったことがあります。
ローカル軽量LLMだけで専門記事から自然な動画台本を作るのは、現時点ではまだ難しい。
一方で、Claudeのような外部LLMを組み合わせれば、実用レベルまで一気に近づくことも分かりました。
これは失敗ではありません。
ホームラボを作って実際に試したからこそ得られた、一つの知見です。
そして何より、
n8n
Ollama
Irodori
Whisper
ComfyUI
FFmpeg
動画生成API
ここまではすべてつながっています。
詰まったのはパイプライン全体ではなく、
「どのLLMに台本生成を任せるか」
という最後の部品選びでした。
だから今は、その用途に最適なモデルを選びながら、動画自動生成の完成を目指していこうと思います。
動画台本生成、ローカルLLMの限界が見えたのでClaude haiku/sonnetを試した
 AI制作・自動化
コメント