私はこれまで、note記事やKindleを中心に、文章でさまざまな成果物を作ってきました。
文章は、自分の考えや経験を整理して伝えるには、とても向いています。
一方で、発信の形式が文章だけだと、届く相手や使える場面はどうしても限られます。
書いた記事や本の内容を、簡単な解説動画にもできれば、
YouTube
SNS
ブログ
商品紹介
講座
音声付き教材
など、発信の幅をかなり広げられます。
そこで以前から、
note記事やKindleの内容を、あまり手間をかけずに動画へ変えられないか
と考えていました。
もちろん、Filmoraなどの動画編集ソフトを使えば動画は作れます。
ただ、毎回、
台本を整える
音声を作る
字幕を付ける
画像を並べる
動画として書き出す
という作業を繰り返すのは、どうしても手間がかかります。
私は本業や家庭の合間に制作しているため、動画一本ごとに細かい編集作業をするのは現実的ではありません。
その一方で、自宅にはLinuxパソコンがあり、Codexやn8nも使えるようになっていました。
音声生成、字幕作成、FFmpegによる動画化、NASへの保存なども、少しずつ試していました。
そこで、
それなら、自分で動画作成フローそのものを作れないか
と考えました。
目指したのは、スマートフォンから、
画像
字幕として表示する文章
音声として読ませる文章
を入れるだけで、自宅のパソコンが音声、字幕、動画を自動で作る仕組みです。
最初は、単なる実験のつもりでした。
しかし、Codexで少しずつ機能を追加し、全20フェーズに分けて開発を進めた結果、実際にスマートフォンから使える動画生成システムまで完成しました。
ところが、完成した動画を再生してみると、機械的なテストでは分からなかった大きな問題が残っていました。
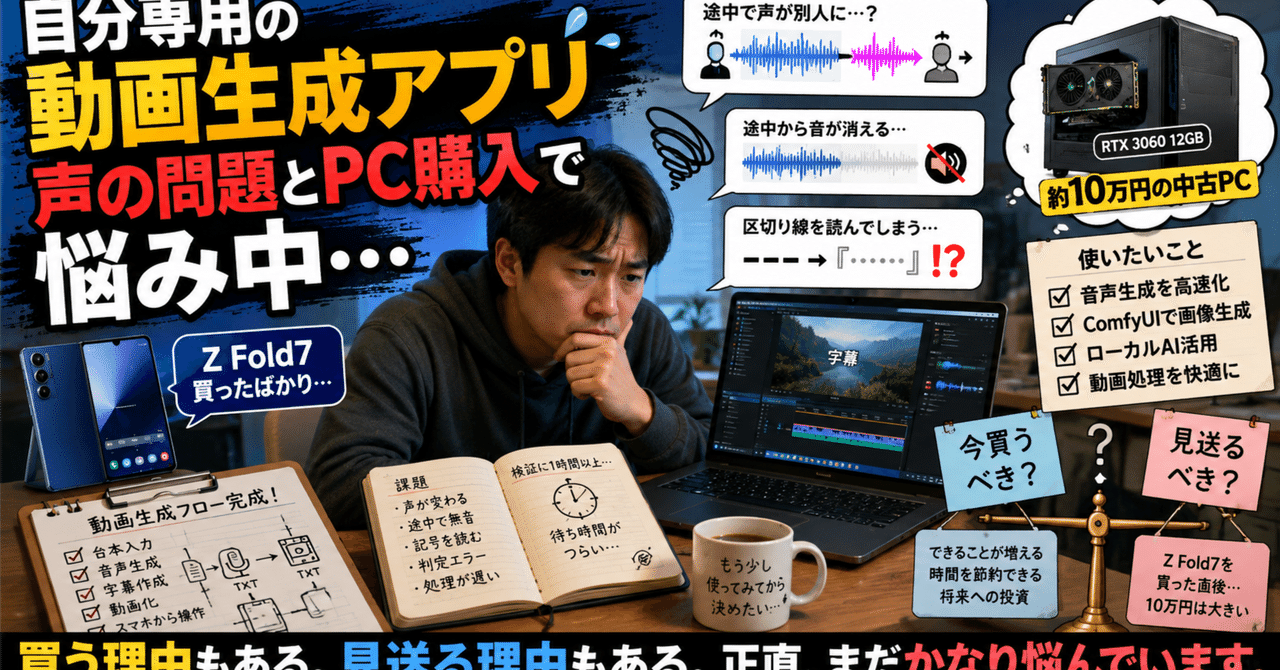
動画の途中で、ナレーションの声が突然、別人のように変わっていたのです。
動画の途中で、話している人が変わったように聞こえる
動画の前半は特に問題ありませんでした。
しかし、途中からナレーションの声が明らかに変わりました。
声が少し高くなった、話し方が少し変わった、という程度ではありません。
聞いている側が、
途中から別の人が話しているのでは?
と感じるほどの変化です。
動画ファイル自体は正常に作られています。
字幕も表示されます。
音声も入っています。
それでも、途中で話者が変わったように聞こえると、動画全体がとても不自然になります。
映像が多少単調でも、字幕のデザインが地味でも、内容を見ることはできます。
しかし、ナレーションが突然別人になる違和感はかなり大きいです。
仕組みとしては完成している。
けれど、そのまま公開できる品質ではない。
最後に残っていた大きな課題は、音声を最初から最後まで同じ声に保つことでした。
同じ声を選んでいるのに、なぜ変わるのか
最初に疑ったのは、文章ごとに別の声が選ばれている可能性です。
調べてみると、すべての文章で同じ音声設定を使っていました。
声の種類、話す速さ、音声生成の設定なども同じです。
設定ミスで別の声が選ばれていたわけではありませんでした。
ただし、一つ重要な違いがありました。
音声を作るたびに、生成結果へ影響するランダムな値が使われていたのです。
AIによる音声生成では、同じ文章と同じ声を指定しても、毎回まったく同じ音声になるとは限りません。
少し話し方が変わったり、声の高さや抑揚が変わったりすることがあります。
今回のシステムでは、長い文章を短いかたまりに分け、それぞれ別々に音声化していました。
たとえば35個に分けた文章なら、音声生成も35回行います。
一回ごとの差は小さくても、何十回も繰り返すと、その中に声が大きく変わる部分が混ざる可能性があります。
今回の「途中から別人に聞こえる」問題は、この影響が大きいと考えました。
毎回同じ条件で音声を作るようにした
そこで、音声生成に使うランダムな値を、動画ごとに固定するようにしました。
この値は一般に「seed」と呼ばれます。
同じ文章、同じ音声設定、同じseedを使えば、同じ結果を再現しやすくなります。
実際に、同じ文章を同じ設定で2回音声化して比較したところ、できあがった音声ファイルは完全に同じものになりました。
「なんとなく似た声になった」という話ではありません。
ファイルの中身まで一致していました。
これにより、音声を作り直すたびに声がランダムに変わる状態は防げます。
不自然な部分だけを作り直せるようにした
ただし、seedを固定すれば必ず自然な音声になるわけではありません。
文章の長さや言葉の組み合わせによっては、不自然な読み方になることがあります。
そこで、生成した音声について、
音量が周囲と大きく違わないか
長さが極端ではないか
声の高さが急に変わっていないか
前後の音声と比べて不自然ではないか
を確認する仕組みも追加しました。
問題がありそうな部分が見つかったとき、動画全体を最初から作り直す必要はありません。
正常な部分はそのまま使い、不自然な部分だけを再生成します。
その後、新しい音声の長さに合わせて、字幕の表示時間と動画も作り直します。
音声だけを途中で差し替えると、字幕とのタイミングがずれる可能性があるためです。
正常な部分を再利用しながら、問題がある部分だけを直せるようになりました。
音声を直したら、今度は動画がエラーになった
音声の改善機能を追加し、再び動画を生成しました。
文章の音声化は完了しました。
不自然な可能性がある部分の作り直しも終わりました。
ところが、最後に動画を作るところでエラーになりました。
表示されたのは、完成した動画が指定された条件と一致していない、という内容でした。
映像の形式、画面サイズ、再生時間などのどれかが合っていないと判定されたのです。
最初は、音声を一部作り直したことで長さが変わり、字幕や動画とずれたのだと思いました。
しかし詳しく調べると、動画自体は正しく作られていました。
問題は、完成した動画の長さを確認する方法でした。
動画ファイルには、全体の再生時間と、映像部分だけの再生時間など、複数の時間情報が入っています。
この確認処理が、実際の動画全体ではなく、少し短い映像側の時間を使っていました。
そのため、正常な動画なのに「長さが合っていない」と誤判定していたのです。
確認方法を修正すると、
映像形式
音声形式
画面サイズ
音声の長さ
字幕の終了時刻
動画全体の長さ
が問題なく一致するようになりました。
再生できたのに、途中から音が聞こえなくなった
修正後の動画は、スマートフォンから再生できました。
ところが実際に見てみると、今度は途中から音が聞こえなくなりました。
システム上では、音声は最後まで存在しています。
動画と音声の長さもほぼ同じです。
それでも、スマートフォンで再生すると途中から無音になります。
調べてみると、動画ファイルそのものが無音になっていたわけではありませんでした。
問題は、スマートフォンへ動画を送る仕組みです。
スマートフォンやWebブラウザで動画を見るとき、必ずしも最初からファイル全体を読み込むわけではありません。
必要な部分だけを少しずつ取得したり、途中へ移動したときに、その位置から動画データを読み込んだりします。
今回の配信機能は、この「動画の一部分だけを送る」という仕組みに十分対応していませんでした。
そのため、最初からの再生はできても、途中再生や先読みのタイミングで音声が正しく取得できない可能性がありました。
そこで、動画の途中部分だけを正しく送れるように配信機能を修正しました。
修正後は、スマートフォンで動画の途中へ移動しても、音声が続けて再生されるようになりました。
区切り線まで音声として読まれていた
さらに、実際に聞いて初めて分かった問題がありました。
字幕と文章の区切りとして入れていた、
—
のような記号を、音声生成AIがそのまま読もうとしていたのです。
人間にとっては単なる区切り線です。
しかし、音声生成AIから見れば、入力された文字の一部です。
そのため、区切りの場所で意味不明な音声が入りました。
そこで、音声を作る直前に文章を確認し、区切り線や装飾目的の記号だけでできた行は読ませないようにしました。
その場所には短い無音時間を入れます。
一方で、普通の文章中にある長音記号やハイフンまで削除すると、文章そのものを壊してしまいます。
そのため、
区切り線だけの行
装飾記号だけの行
空白だけの部分
読み上げる内容がない部分
だけを対象にしています。
字幕の区切りはそのまま残し、音声生成へ送る文章だけを調整しました。
約2分50秒の動画を、最後まで普通に見られた
最終テストでは、35個に分けた文章から約2分50秒の動画を作りました。
音声生成、字幕作成、動画化まで最後まで完了しました。
実際にスマートフォンで最初から最後まで再生したところ、
音声が途中で消えない
動画の途中へ移動しても再生できる
区切り線を変な音で読まない
字幕と音声がずれない
途中で別人のように声が変わりにくい
ことを確認できました。
機械的に「成功」と表示されるだけではありません。
人間が実際に見て、聞ける品質まで到達しました。
ただし、検証だけで1時間以上かかる
品質は大きく改善しました。
しかし、別の課題がより明確になりました。
とにかく時間がかかります。
音声生成、品質確認、部分再生成、動画化、実際の視聴まで含めると、検証に1時間以上かかることがあります。
現在使っている自宅のLinuxパソコンは、10年以上前のCPUを搭載した古いノートパソコンです。
GPUはありません。
音声生成もCPUで動かしています。
動画生成フローそのものは完成しました。
しかし、処理速度が実用性の次のボトルネックになっています。
GPU版なら長文をまとめて生成できるのか
もし音声生成をGPUで動かせば、処理時間は大きく短縮できる可能性があります。
現在は、文章を数秒単位の細かいセグメントへ分けて生成しています。
CPUでも失敗時の影響を小さくでき、部分再生成しやすいという利点があります。
一方で、細かく分けるほど、セグメントごとの抑揚や声質が変化しやすくなります。
GPUで処理速度に余裕ができれば、
セグメントを20秒から40秒程度へまとめる
文脈を含んだ長めの単位で生成する
抑揚を自然につなげる
複数パターンを試す
問題区間だけ高速に再生成する
といった運用がしやすくなります。
長文を一度に生成すれば必ず自然になるとは限りません。
長文特有の読み崩れや、失敗時の再生成コストもあります。
それでも、現在の3秒から8秒程度の細切れ生成より、話者の一貫性や抑揚を保ちやすくなる可能性があります。
現実的には、完全な一括生成ではなく、意味のまとまりごとに少し長く統合する形がよさそうです。
ComfyUIが使えれば画像入力も自動化できる
現在の手動動画生成モードでは、画像は自分で用意してアップロードしています。
音声、字幕、動画化は自動ですが、画像準備はまだ人間の作業です。
自宅の古いパソコンにもComfyUIは入っています。
しかし、GPUがないため、実用速度では動きません。
以前はCPUで画像生成を試していましたが、時間がかかるうえ、生成品質も十分ではありませんでした。
そのため、現在はComfyUIの自動起動を無効化し、動画生成フローから事実上外しています。
将来GPUマシンを導入すれば、ComfyUIを画像生成サーバーとして復活させられます。
台本の各セグメントから画像プロンプトを作り、
既存画像ライブラリを優先
足りない場面だけ画像生成
生成画像を自動で動画ジョブへ登録
不適切な画像だけ人間が差し替える
という流れも考えられます。
そうなれば、現在手入力している画像準備もかなり減らせます。
動画生成システムは、
台本と画像を人間が用意するツール
から、
台本を入れると音声、字幕、画像、動画まで作るツール
へ進化します。
約10万円の中古GPUマシンを買うべきか
そこで悩んでいるのが、中古GPUマシンの導入です。
候補は、およそ10万円から11万円。
主な構成は、
第11世代Core i7
メモリ32GB
RTX 3060 12GB
NVMe SSD 1TB
HDD 4TB
です。
現在の古いLinuxパソコンと比べれば、処理能力は大幅に上がります。
RTX 3060のVRAM 12GBがあれば、
音声生成のGPU実行
ComfyUI
ローカル画像生成
一部のローカルAIモデル
動画処理
今後のAI開発
にも使えそうです。
現在の古いパソコンを、n8n、API、スマートフォン入口などの司令塔として残し、GPUマシンを生成専用サーバーにする構成もできます。
技術的には、かなり魅力的です。
Z Fold7を買ったばかりという問題
一方で、最近Galaxy Z Fold7も導入しています。
スマートフォンとしてはかなり高額な買い物でした。
Fold7は実際に、今回のCodex開発やスマートフォン入口の操作で大活躍しています。
画面を分割して、片側でCodex、もう片側でChatGPTやWeb画面を見る。
外出先からSSH接続し、自宅のLinuxパソコン上で開発を進める。
この使い方は、通常のスマートフォンではかなり難しかったと思います。
Fold7は浪費だったとは感じていません。
しかし、購入直後にさらに10万円前後のPCを買うとなると、さすがに悩みます。
ボーナスは出ました。
Kindleも少しずつ売れています。
それでも、副業収益だけで簡単に回収できる金額ではありません。
3月から継続できている
それでも、以前より購入を現実的に考えられる理由があります。
私は3月頃から、AIを使った制作や開発を継続しています。
一時的に触って終わったわけではありません。
ここ数か月で、
Kindleの改訂
note記事
WordPress
動画生成フロー
宣伝支援ツール
スマートフォン入口
NAS保存
Linux環境整備
systemd常駐化
などを少しずつ進めてきました。
今回の動画生成プロジェクトも、全20フェーズを最後まで完了しました。
完成後に問題が出ても、そのまま放置せず、
声が別人になる問題
動画出力の誤判定
スマートフォン途中再生の無音
記号の誤読
字幕同期
まで修正しています。
少なくとも、PCを買って数日で飽きて放置する可能性は、以前よりかなり低いと思います。
すでにGPUを使いたい具体的な用途もあります。
これは「何か面白いことができそう」という段階ではなく、完成した仕組みの処理速度と品質を上げるための設備投資です。
今のところ、まだかなり悩んでいる
正直なところ、まだ結論は出ていません。
GPUマシンを買えば、今よりできることが増えるのは分かっています。
音声生成は速くなるかもしれない。
ComfyUIも、ようやく実用的に使えるかもしれない。
画像を毎回手で用意する作業も減らせるかもしれない。
今作った動画生成システムを、さらに先へ進められる可能性はかなりあります。
候補の中古PCも、性能だけを見れば魅力的です。
第11世代Core i7、メモリ32GB、RTX 3060 12GB、SSD 1TB、HDD 4TB。
10万円前後でこの構成なら、用途にはかなり合っています。
しかも、ボーナスも出ました。
Kindleも少しずつですが売れています。
3月からここまで制作や開発を継続できているので、買ってすぐ飽きて放置する可能性も低いと思います。
それでも、簡単には決められません。
つい最近、Galaxy Z Fold7という大きな買い物をしたばかりです。
Fold7は実際にかなり活用しています。
Codexを動かしたり、自宅PCへ接続したり、スマートフォン入口から動画を確認したりと、今回の開発にも欠かせない道具になっています。
だから、Fold7を買ったことを後悔しているわけではありません。
ただ、そこへさらに10万円前後のPCを追加するとなると、さすがに少し立ち止まります。
副業収益だけで考えれば、すぐに回収できる金額ではありません。
家庭用PC、AI実験機、動画生成機、将来子どもが使うPCという複数の役割を持たせれば、買う理由はいくらでも作れます。
逆に言えば、欲しい気持ちに合わせて理由を並べているだけではないか、とも思います。
今の古いPCでも、時間をかければ動画は完成します。
今回も、約2分50秒の動画を最後まで作れました。
音声も聞ける品質になり、字幕もずれませんでした。
だから、今すぐ買わなければ何も進まないわけではありません。
一方で、毎回の検証に1時間以上かかる状態で、本当に何本も動画を作り続けるのか。
待ち時間が面倒になり、せっかく作った仕組みを使わなくなるのではないか。
GPUがないことで、今後の画像生成や音声生成の改善が止まるのではないか。
そう考えると、買わないことにもコストがあります。
買っても高い。
買わなくても遅い。
すでに用途はある。
でも、今でなければならないのかは分からない。
ボーナスが出た今なら買える。
しかし、買えることと、買うべきことは同じではありません。
今はそんな状態です。
たぶん、もう少し今の動画生成システムを実際に使ってみます。
何本か作ってみて、処理の遅さが本当に継続の妨げになるのかを確認します。
ただ、その結果を待つ前から、RTX 3060 12GBの中古PCがかなり気になっています。
買う理由もあります。
見送る理由もあります。
正直、今はまだかなり悩んでいます。
コメント