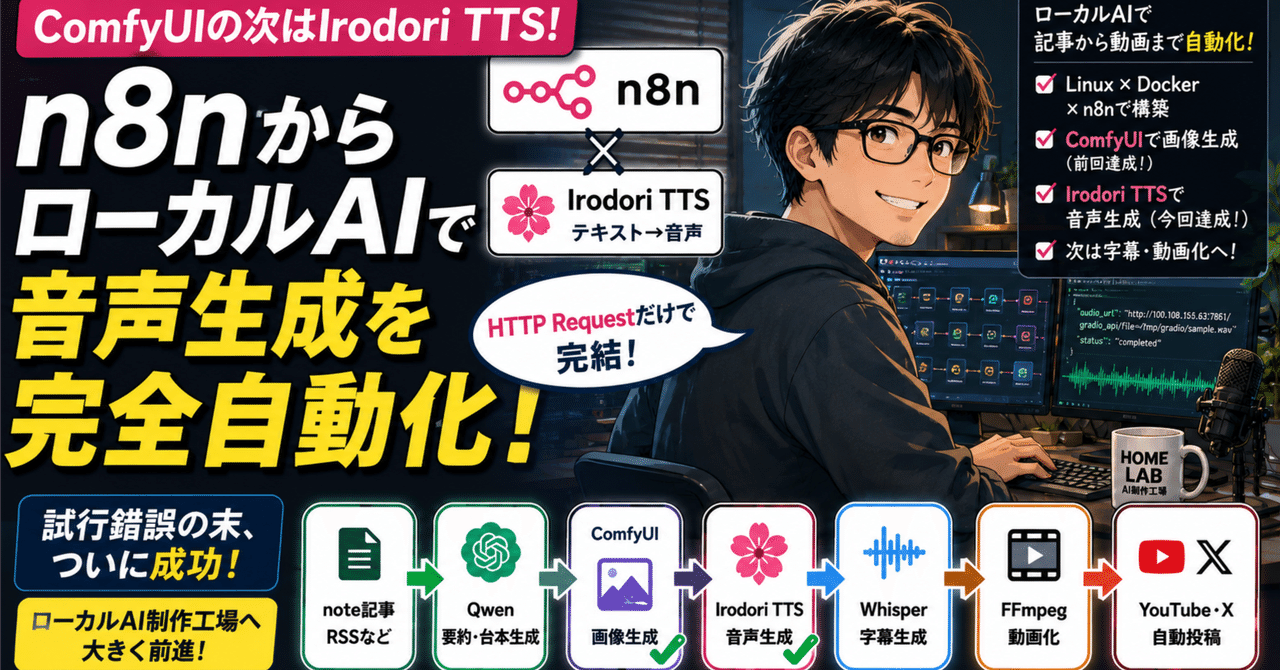
前回の記事では、n8nからComfyUIを呼び出し、画像を自動生成するところまで成功しました。
画像が作れるようになったことで、次はいよいよ音声生成です。
目標は、
「記事を渡したら、自動でナレーション音声まで作る」
そんなワークフローを完成させることでした。
今回の相手はIrodori TTS
Irodori TTS自体は以前から使えていました。
ブラウザで文章を入力すれば、自然な日本語音声を生成できます。
しかし、それでは毎回手作業になります。
欲しいのは、
n8nから自動で音声を作る仕組み。
ここから苦戦が始まりました。
APIとの格闘
最初はPythonからGradio APIを呼び出そうとしました。
しかし、
-
引数の順番が分からない
-
Value is not in the list of choices
-
APIには届くのに動かない
-
Pythonでもエラー
など、試行錯誤の連続。
さらに、UIでは普通に音声生成できるのに、APIでは失敗するという状態にも悩まされました。
最も苦労したのは、
「APIは存在するのに404になる」
という状況です。
最初は、
/api/predict/_run_generation
を呼び出していました。
しかし何度試しても404エラー。
しかも途中では接続先IPを間違えていたため、タイムアウトまで発生。
IPを修正すると通信自体は成功しましたが、それでも404は変わりませんでした。
ここで、
「通信はできている。ということは、URLそのものが違うのでは?」
と考え直すことにしました。
UIからヒントを探す
発想を変え、
「UIは裏で何を送っているのか」
を調査。
Gradioの設定ファイルを解析し、
-
エンドポイント
-
入力パラメータ
-
引数の順番
を一つずつ確認していきました。
そこで分かったのが、
Gradio 5系ではAPIの入口が変わっていた
ということです。
これまで使っていた
/api/predict/…
ではなく、
/gradio_api/call/…
が正しいエンドポイントでした。
半信半疑でURLを書き換えて実行すると、
それまで404しか返ってこなかったAPIから、
event_id
が返ってきました。
「あ、やっと正しい入口を見つけた。」
ここが今回一番うれしかった瞬間です。
たどり着いた答え
最初はPythonスクリプトが必要だと思っていました。
実際、PythonでAPIを試しながら挙動を確認したことで、Gradioの仕組みを理解することができました。
しかし最終的には、
HTTP Requestノードだけ
で完結できることが判明しました。
ワークフローは、
POSTでevent_id取得
↓
GETで生成完了待機
↓
音声URL取得
↓
WAVダウンロード
copy
という、Gradio独特のイベント方式でした。
Pythonで試行錯誤したことが、結果的に「Pythonを使わなくても実現できる方法」へたどり着く近道になったのです。
ついに完全自動化
最終的には、
-
音声生成開始
-
生成完了待機
-
音声URL取得
-
WAVファイル取得
まで、すべてn8nだけで成功。
PythonもExecute Commandも不要でした。
思わぬところで気付いた課題
実は、この作業の途中で別の問題にも気付きました。
気が付くと、パソコンのファンの音が以前より大きくなっていました。
「何か動きっぱなしなのでは?」
と思い、メモリ使用量を確認すると、16GB中14GB近くが使われている状態。
そこでhtopでプロセスを確認してみると、試しに起動したComfyUIとIrodori TTSが、そのままバックグラウンドで動き続けていることが分かりました。
ブラウザを閉じても、AIモデルはメモリを保持したまま待機していたのです。
その結果、生成を繰り返すたびにメモリを圧迫し、パソコンの動作も重くなっていました。
そこで、まずSwapの使用状況を確認。以前メモリ不足になった際のデータが残っていたため、一度RAMへ戻して整理しました。
さらに、ComfyUIとIrodori TTSをsystemdサービスとして登録。
これにより、
-
必要なときだけ起動
-
使い終わったら停止
-
起動用ターミナルを探す必要がない
-
PC再起動後も簡単に管理できる
という運用に変更できました。
今回の目的は音声生成の自動化でしたが、その過程でホームラボ全体の運用方法まで改善できたのは思わぬ収穫でした。
一歩ずつ動画生成システムへ
今回完成したのは、動画生成パイプラインの音声生成部分です。
現在の構想は、
note記事
↓
Qwenで要約・台本生成
↓
ComfyUIで画像生成 ✅
↓
Irodori TTSで音声生成 ✅
↓
Whisperで字幕生成
↓
FFmpegで動画化
↓
YouTube・Xへ投稿
copy
ここまで来ると、ようやく目指していた「ローカルAI制作工場」の形が少しずつ見えてきました。
LinuxもDockerもn8nも、数日前まではほとんど初めてでした。
それでも、一つずつエラーを解決しながら進めた結果、自動化だけでなく、その環境を安定して運用する仕組みまで整い始めています。
次はいよいよ、Whisperによる字幕生成とFFmpegによる動画自動生成。
画像・音声までは自動化できたので、ここまで完成すれば、
記事 → 台本 → 画像 → 音声 → 字幕 → 動画
という一連の流れが、ローカルAIだけで完結する「AI制作工場」にかなり近づくはずです。
まだ試行錯誤は続きますが、一歩ずつ積み上げながら、自分だけのAI制作環境を完成させていこうと思います。
コメント