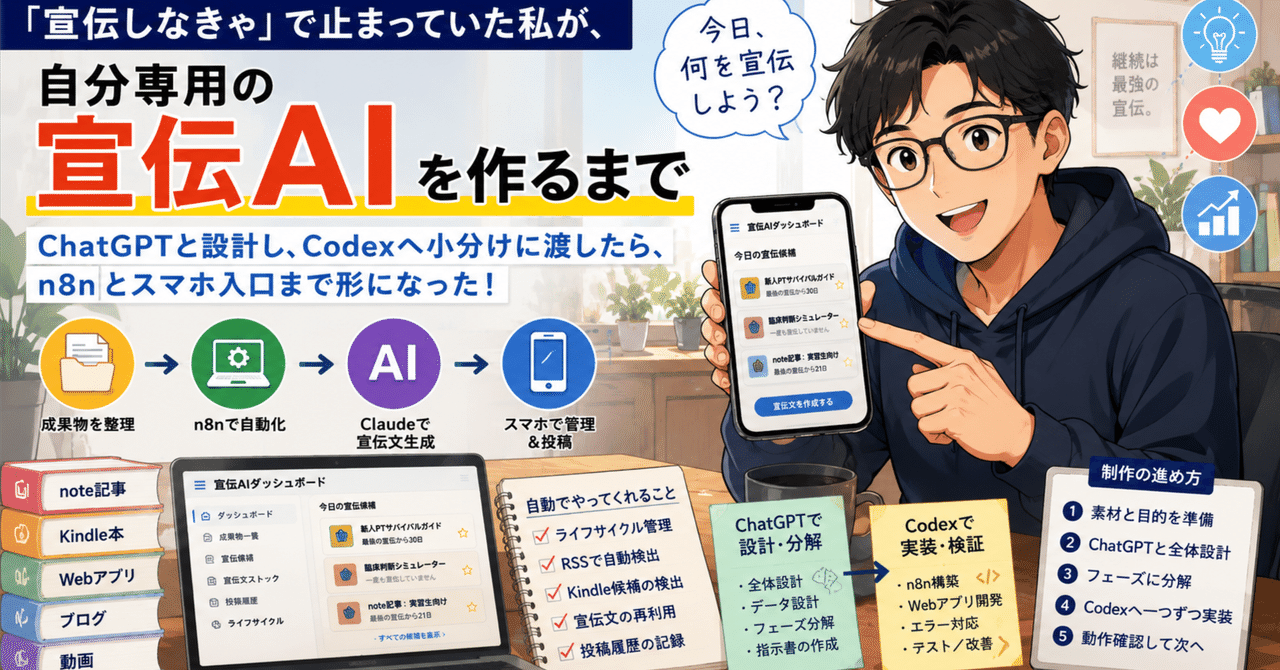
- 最初に考えていたのは、もっと単純な宣伝AIだった
- 宣伝AIではなく、自分専用CMSだった
- まず自分で準備したもの
- ChatGPTには、実装ではなく設計を頼んだ
- Phase 1:成果物を機械が読める形にする
- Phase 2:最近宣伝していないものを提案する
- Phase 3:Claude APIで宣伝文を複数生成する
- Phase 3.5:作った宣伝文を使い捨てない
- Phase 4:スマホから使える入口を作る
- Phase 5:宣伝だけでなく、成果物の成長を管理する
- Phase 6:スマホから成果物を追加・編集する
- Phase 6.5:noteとWordPressはRSSから見つける
- Phase 7:Kindleも増えたら候補として検出する
- Codexへは、長い指示を直接送らなかった
- n8nは簡単ではなかった
- AIに丸投げしたのではなく、AIチームを組んだ感覚だった
- いきなり全部作らせなかったことが一番大きかった
- 成果物を作るだけの段階から、資産を回す段階へ
- おわりに
成果物を作ること自体は、かなり得意になってきました。
note記事、Kindle、Webアプリ、ブログ、動画。
思いついたものをAIと相談しながら形にしていく速度は、数か月前とは比べものになりません。
一方で、ずっと苦手なことがありました。
作ったものを宣伝することです。
新しい記事を公開した直後は紹介できても、しばらくすると存在自体を忘れてしまいます。
Kindleも冊数が増えるほど、
-
最後にいつ宣伝したのか
-
どの本を最近紹介していないのか
-
どの記事とどの本が関連しているのか
-
同じ宣伝文ばかり使っていないか
が分からなくなってきました。
成果物が少ないうちは、頭の中やメモで何とかなります。
しかし、noteが200記事を超え、Kindleやアプリ、WordPress、動画まで増えてくると、もはや個人の記憶で管理できる量ではありません。
そこで今回、
自分の成果物を管理し、最近宣伝していないものを提案し、宣伝文まで作ってくれる自分専用AI
を作ることにしました。
ただし、私はコードを自力で全部書けるわけではありません。
今回やったのは、
私が素材と目的を準備する
ChatGPTと全体設計を固める
作業を小さなフェーズに分解する
Codexへ一つずつ実装してもらう
という進め方でした。
結果として、単なる「宣伝文生成フォーム」ではなく、成果物の管理、宣伝履歴、宣伝文の再利用、RSS同期、Kindle候補の検出まで見据えた、かなり本格的な自分専用CMSへ発展しました。
今回は、その制作過程をまとめます。
最初に考えていたのは、もっと単純な宣伝AIだった
最初の構想は、とても単純でした。
成果物のタイトルや概要を入力すると、AIが宣伝文を作ってくれる。
イメージとしては、こんな流れです。
商品名を入力
↓
概要を入力
↓
対象者を入力
↓
Claude API
↓
宣伝文を生成
copy
実際、n8nのフォームを使えば、この程度なら比較的すぐ作れます。
私にはすでに、動画生成プロジェクトで作ったスマホ向けの受付フォームがありました。
スマホから内容を入力し、n8nがジョブとして受け付け、NASへ保存する仕組みです。
その構造を宣伝AIにも流用できると思いました。
しかし、よく考えると問題がありました。
私はすでに、宣伝対象となる成果物を大量に持っています。
毎回、
-
商品名
-
概要
-
対象者
-
魅力
-
URL
を入力するのは、かなり面倒です。
それでは、宣伝を楽にするためのツールなのに、入力作業が新しい負担になります。
必要なのは、毎回内容を入力するフォームではありませんでした。
必要だったのは、
すでに登録されている成果物から、今日宣伝するものを選んでくれる入口
でした。
宣伝AIではなく、自分専用CMSだった
構想をChatGPTと整理していくうちに、作りたいものの正体が見えてきました。
これは単なる宣伝文生成AIではありません。
自分専用のコンテンツ管理システムです。
全体像は、こうなりました。
自分専用Webアプリ
├─ 成果物一覧
├─ 今日の宣伝候補
├─ 宣伝文作成
├─ 宣伝文ストック
├─ 投稿履歴
└─ 横展開の進捗管理
        │
        ▼
n8n Webhook API
├─ assets.jsonを読む
├─ 宣伝候補を計算
├─ Claude APIで宣伝文を生成
├─ 宣伝文を保存
├─ 投稿履歴を保存
└─ ライフサイクルを更新
copy
Webアプリは、私がスマホから使う入口です。
n8nは、裏側の処理を担当します。
AIは、何を宣伝するかを決めるのではなく、選ばれた成果物の宣伝文を作る役割に限定しました。
この役割分担が重要でした。
まず自分で準備したもの
AIへすべてを丸投げしたわけではありません。
最初に、私自身が持っている素材を整理しました。
用意したのは、主に次のようなものです。
-
Kindleの本文txt
-
Kindleの表紙画像
-
各成果物の紹介文
-
note、Kindle、アプリなどのURL一覧
-
誰のどんな悩みに役立つかを整理した資料
-
既存のポートフォリオ資料
フォルダ内には、
サバイバル1.txt
サバイバル2.txt
ステップ1.txt
ステップ2.txt
ナース.txt
AI.txt
copy
のようなKindle本文があり、
survival1.jpeg
stepup1.jpeg
nurse.jpeg
ai1.jpeg
copy
のような表紙画像も置きました。
さらに、
advertisement.txt
advertisement2.txt
URL_list.txt
copy
といった、紹介文やURLをまとめた資料も準備しました。
重要だったのは、AIにいきなり全本文を読ませなかったことです。
Kindle本文を何冊分も全文解析させれば、時間もトークンも消費します。
そこで、
まず紹介文とURL一覧を使う
不足する場合だけ、該当する本文を部分的に確認する
というルールにしました。
ChatGPTには、実装ではなく設計を頼んだ
このプロジェクトで、ChatGPTに一番頼ったのはコード作成ではありません。
作業の分解です。
「宣伝AIを作って」とCodexに一度で渡せば、おそらくかなりの量を一気に実装しようとします。
そうすると、
-
途中で仕様がぶれる
-
エラーの原因が分からなくなる
-
Codexの利用枠を大量に消費する
-
修正範囲が広くなる
-
一部が動かないまま次へ進む
という危険があります。
そこで、ChatGPTと相談しながら、作業をフェーズに分けました。
Phase 1:成果物を機械が読める形にする
最初にやったのは、宣伝文生成ではありません。
成果物の整理です。
本文、表紙、紹介文、URLの対応関係をCodexに確認してもらい、assets.jsonへ登録しました。
例えば、1冊のKindleはこのようなデータになります。
{
  "id": "kindle_survival_01",
  "title": "新人理学療法士のサバイバルガイド",
  "type": "kindle",
  "category": "新人PT",
  "audiences": [
    "新人理学療法士",
    "実習生"
  ],
  "problems": [
    "患者さんの前で何をすればいいか分からない",
    "バイタルを見ても動かしてよいか判断できない"
  ],
  "benefits": [
    "臨床1年目の優先順位を整理できる"
  ],
  "url": "AmazonのURL",
  "image_path": "survival1.jpeg",
  "priority": 5,
  "cooldown_days": 14
}
copy
この段階では、代表的な成果物を3件だけ登録しました。
最初から全書籍を登録しなかったのも、Codexの枠を節約するためです。
3件で構造を検証し、問題がないことを確認してから増やす方針にしました。
Phase 2:最近宣伝していないものを提案する
次に作ったのが、宣伝候補を返すn8n APIです。
ここではAIを使いません。
宣伝候補は、決められたルールから機械的に計算します。
例えば、
優先度
最後の宣伝からの日数
一度も宣伝していないか
最近更新されたか
同じカテゴリを最近宣伝していないか
copy
などを使います。
考え方は、次のようなものです。
候補スコア
= 優先度
+ 最後の宣伝からの日数
+ 未宣伝ボーナス
+ 更新ボーナス
- 直近使用ペナルティ
copy
これにより、
臨床判断シミュレーター
一度も宣伝していません

新人PTサバイバルガイド
最後の宣伝から30日経過しています
copy
のような提案ができるようになりました。
AIに候補選定まで任せなかったことで、結果が安定し、API利用料もかかりません。
Phase 3:Claude APIで宣伝文を複数生成する
宣伝文生成にはClaude APIを使いました。
私はClaude API側に残高が多く入っていたため、OpenAI APIではなくClaudeを選びました。
ただし、AI Agentは使っていません。
単純に、
assets.jsonの成果物情報
+
宣伝文用プロンプト
↓
Claude API
↓
構造化JSON
copy
という形です。
1回の生成で、切り口の異なる複数案を作ります。
例えば、
-
悩みから入る
-
質問から入る
-
実体験から入る
-
実用Tipsとして見せる
-
関連する無料コンテンツへつなぐ
といったパターンです。
出力は自由文ではなく、JSONにしました。
{
  "asset_id": "kindle_survival_01",
  "channel": "x",
  "variants": [
    {
      "type": "problem_solution",
      "label": "悩みから入る",
      "text": "投稿本文"
    }
  ]
}
copy
JSONにすることで、n8nでもWebアプリでも扱いやすくなります。
Phase 3.5:作った宣伝文を使い捨てない
途中で、新しい問題に気づきました。
毎回Claude APIで宣伝文を作る必要はないのではないか。
一度良い宣伝文ができたなら、一定期間を空けて再利用できます。
そこで、生成した宣伝文を、
promotion_library.jsonl
copy
へストックする機能を追加しました。
宣伝文ごとに、
-
使用回数
-
最終使用日
-
評価
-
切り口
-
状態
-
文章ハッシュ
を保存します。
成果物を選んだ時は、いきなりClaude APIを呼びません。
最初に過去のストックを表示します。
既存の宣伝文を見る
↓
使えるものがあればコピー
↓
不足した時だけ新しく生成
copy
これにより、API利用を減らしながら、良い宣伝文を資産として残せます。
作るほど宣伝文ライブラリが育っていく仕組みです。
Phase 4:スマホから使える入口を作る
ここで、ようやく自分専用のWebアプリを作りました。
技術構成は、
Vite
React
TypeScript
copy
です。
n8nをバックエンドとして使うため、Next.jsのようなサーバー機能は使いませんでした。
スマホの入口には、
-
成果物数
-
今日の宣伝候補
-
既存の宣伝文
-
新規生成
-
コピー
-
投稿済み記録
-
投稿履歴
を表示します。
重要なのは、
コピーしただけでは投稿済みにしない
ことです。
コピーと投稿記録を分け、実際に投稿した後で「投稿済み」を押す設計にしました。
こうして、投稿履歴が次回の宣伝候補へ反映されます。
Phase 5:宣伝だけでなく、成果物の成長を管理する
成果物は、公開したら終わりではありません。
例えばnote記事なら、
noteのみ
↓
WordPressへ移行
↓
動画化
↓
Kindleへ収録
↓
宣伝
copy
と横展開できます。
そこで、各成果物にライフサイクルを持たせました。
{
  "lifecycle": {
    "note": "published",
    "wordpress": "not_started",
    "video": "not_started",
    "kindle": "included",
    "app": "none"
  }
}
copy
Webアプリ上で、
-
WordPress移行待ち
-
動画未作成
-
Kindle収録済み
-
今週宣伝済み
-
長期間未宣伝
を確認できるようにしました。
この時点で、宣伝AIというよりも、私の成果物全体を管理するCMSになっていました。
Phase 6:スマホから成果物を追加・編集する
noteやKindleは今後も増えます。
毎回JSONファイルを直接編集するのは大変です。
そこで、Webアプリから新規成果物を追加・編集できるフォームを作りました。
入力できるのは、
-
タイトル
-
URL
-
対象者
-
読者の悩み
-
得られること
-
宣伝用フック
-
表紙画像
-
優先度
-
関連成果物
-
ライフサイクル
などです。
削除は物理削除ではなく、アーカイブ扱いにしました。
誤操作で成果物データを消さないためです。
Phase 6.5:noteとWordPressはRSSから見つける
今後、noteやWordPressの記事が増えるたびに手動登録するのも手間です。
そこで、RSSから新しい記事を検出できるようにしました。
流れは、
RSS取得
↓
登録済みURLと比較
↓
新しい記事を発見
↓
登録候補として保存
↓
Webアプリで確認
↓
承認後にassets.jsonへ登録
copy
です。
いきなり正式登録しないのがポイントです。
自動取得した情報は、まずpending_reviewとして候補に入ります。
本人が内容を確認してから登録します。
これなら、誤登録を防ぎながら自動化できます。
Phase 7:Kindleも増えたら候補として検出する
KindleはnoteのようにRSSで簡単に取得できません。
そこで、
-
Kindle本文txt
-
表紙画像
-
advertisement資料
-
URL一覧
-
Amazon著者ページ
を比較し、未登録の書籍を候補として検出する仕組みを考えました。
ただし、Amazon著者ページは変更や取得制限の影響を受けやすいため、補助扱いです。
中心になるのは、ローカルにある素材です。
本文txt
+
表紙
+
紹介文
+
URL
↓
未登録Kindle候補
copy
対応関係が曖昧な場合は、AIに勝手に決めさせません。
要確認としてWebアプリに表示し、私が対応を確定します。
Codexへは、長い指示を直接送らなかった
今回、かなり効果があったのが、指示をMarkdownファイルとして用意したことです。
例えば、
CODEX_PHASE3_CLAUDE_GENERATE_RECORD.md
CODEX_PHASE3_5_PROMOTION_LIBRARY.md
CODEX_PHASE4_WEBAPP_MVP.md
CODEX_PHASE5_LIFECYCLE.md
CODEX_PHASE6_ASSET_EDITOR.md
CODEX_PHASE6_5_RSS_SYNC.md
CODEX_PHASE7_KINDLE_CANDIDATES.md
copy
という形で、フェーズごとの指示書を作りました。
Codexへ送る文章は、毎回ほぼこれだけです。
/home/AI/promotion-agent/CODEX_PHASE4_WEBAPP_MVP.md を読んで、
記載されたPhase 4の作業だけを実施してください。

Phase 5以降へは進まず、
完了条件を満たして報告した時点で停止してください。
copy
長い仕様を毎回チャット欄へ貼る必要がありません。
Codex側も、やるべきことと、やってはいけないことを確認しやすくなります。
n8nは簡単ではなかった
n8nはノーコードツールとして紹介されることが多いです。
しかし、実際に自分の環境で本格的な仕組みを作ると、
-
Docker
-
ボリュームマウント
-
ファイル権限
-
Webhook
-
JSON
-
Credential
-
API
-
エラー処理
-
再起動
-
ワークフローのエクスポート
など、多くの要素が絡みます。
見た目はノーコードでも、実態はかなりシステム開発に近いです。
実際、今回もエラーは何度も出ました。
JSONが壊れる、パスが合わない、Webhookが返らない、ファイル操作に失敗する。
人間だけで一つずつ調べていたら、かなり消耗していたと思います。
Codexは、
エラーを再現
↓
原因を切り分け
↓
修正
↓
再起動
↓
テスト
↓
ワークフローを保存
copy
まで進めてくれました。
私は、何を作るか、どこまで自動化するか、どんな画面が欲しいかを考える。
Codexは、配線と実装と検証を担当する。
かなり良い役割分担でした。
AIに丸投げしたのではなく、AIチームを組んだ感覚だった
今回の制作を振り返ると、単純に「AIに作ってもらった」という感覚ではありません。
私自身が、
-
持っている成果物を整理する
-
必要な素材を集める
-
欲しい機能を言葉にする
-
完成後の使い方を考える
-
各フェーズの結果を確認する
という役割を担いました。
ChatGPTは、
-
全体像の整理
-
機能分解
-
データ設計
-
フェーズ設計
-
Codex向け指示書の作成
を担当しました。
Codexは、
-
n8nワークフローの実装
-
Webアプリの実装
-
ファイル操作
-
エラー対応
-
テスト
-
ドキュメント更新
を担当しました。
Claude APIは、宣伝文生成を担当します。
つまり、
私:目的と判断
ChatGPT:設計と分解
Codex:実装と検証
Claude API:文章生成
n8n:自動化の実働
copy
というチーム構成です。
いきなり全部作らせなかったことが一番大きかった
今回のポイントは、AIの性能よりも、仕事の渡し方だったと思います。
最初から、
成果物を全部管理して、宣伝文を作り、スマホアプリにして、RSSも取得して、Kindleも検出して
と頼んでいたら、途中で崩れていた可能性が高いです。
実際には、
3件だけ登録
↓
候補だけ返す
↓
宣伝文を作る
↓
履歴を保存する
↓
過去文を再利用する
↓
スマホ画面を作る
↓
横展開を管理する
↓
新規成果物を追加する
↓
RSS同期する
↓
Kindle候補を検出する
copy
と、一段ずつ積み上げました。
各フェーズには、必ず、
-
今回やること
-
今回やらないこと
-
テスト内容
-
完了条件
-
次へ進まず停止すること
を書きました。
これによって、Codexの暴走や作りすぎを防げました。
成果物を作るだけの段階から、資産を回す段階へ
これまでは、とにかく成果物を増やしていました。
noteを書く。
Kindleにする。
アプリを作る。
動画にする。
しかし、作ったものが増えるほど、それを管理し、再利用し、届け直す仕組みが必要になります。
今回作った宣伝AIは、単にSNS投稿を作る道具ではありません。
私にとっては、
これまで作ってきた成果物を、眠らせずに回し続けるための基盤
です。
成果物が増えた時に、手作業も同じ割合で増えるのでは意味がありません。
自動化の価値は、作業を一度楽にすることではなく、
成果物が増えても、人間の負担が同じ速度で増えない構造を作ること
にあるのだと思います。
おわりに
私はプログラマーではありません。
n8nもDockerも、少し前までほとんど触ったことがありませんでした。
それでも、
-
自分で素材を準備する
-
ChatGPTと設計する
-
作業を小さく分ける
-
Codexへ順番に渡す
-
動作を確認して次へ進む
という方法なら、かなり本格的なシステムまで作れるようになりました。
AIに一文で丸投げして、魔法のように完成したわけではありません。
むしろ逆です。
人間が目的と順番を決め、AIが得意な仕事を分担することで、初めて大きなものが安定して完成しました。
今回作ったのは宣伝AIですが、この方法は他の自動化にも使えます。
WordPress移行、動画生成、記事整理、教材作成、ポートフォリオ管理。
一つの巨大な依頼ではなく、小さな完成を積み重ねる。
それが、Codexの利用枠を抑えながら、AIと一緒に実用的なシステムを作る一番現実的な方法なのかもしれません。
コメント