ここ数日、AIホームラボの構築を続けています。
Linuxを入れ、Dockerを入れ、n8nを入れ…。
ComfyUI、Irodori TTS、Whisper…。
一つ動くたびに新しい問題が出てきて、正直「いつ終わるんだこれ」と思うことも何度もありました。
ですが、今回ようやく一つ、大きな区切りまで到達しました。
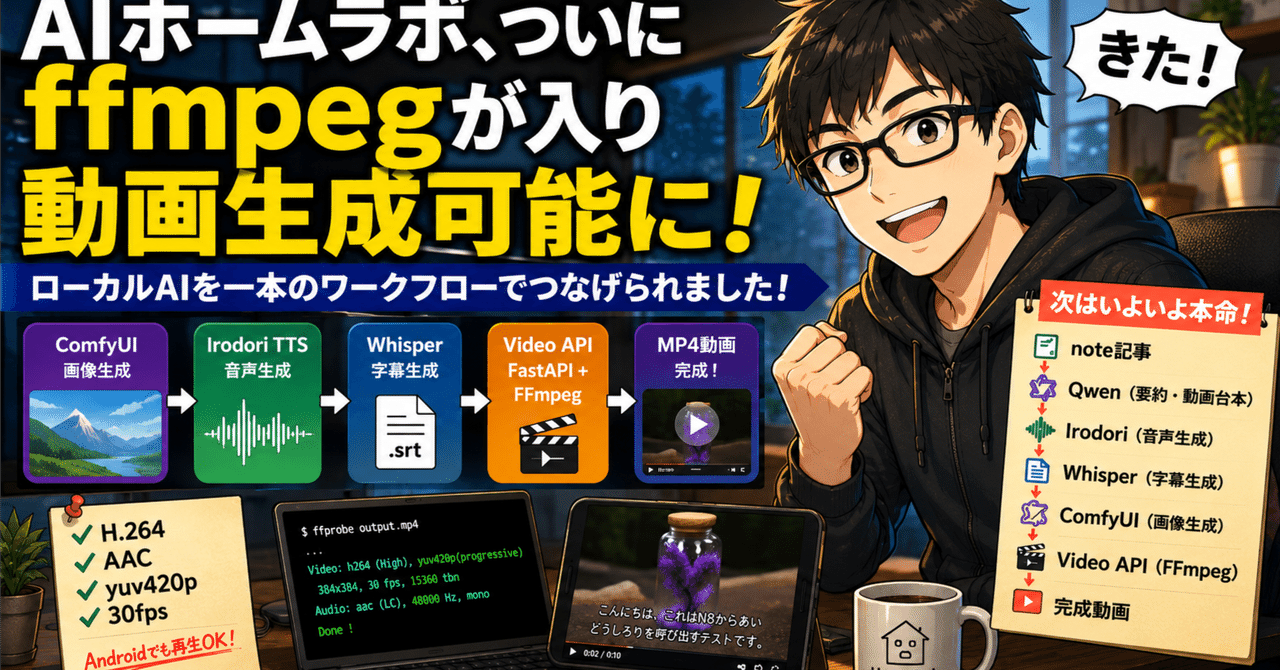
音声・字幕・画像をまとめて動画にするところまで、一つのワークフローとして完成しました。
最初は全部バラバラだった
ここまでの構成は、
ComfyUIで画像生成
Irodori TTSで音声生成
Whisperで字幕生成
FastAPI+FFmpegで動画生成
それぞれは単独で動いていました。
しかし、
「全部つながるのか?」
が一番大きな壁でした。
Video APIも自作しながら修正
動画生成用のFastAPIは最初、
画像+音声
しか受け取れませんでした。
そこでPythonを書き換え、
image_path
audio_path
subtitle_path
output_path
を受け取れるよう変更。
FFmpegにも字幕フィルターを追加しました。
さらにAndroidで再生できるよう、
H.264
AAC
yuv420p
30fps
になるよう調整。
細かい部分ですが、このあたりが意外と重要でした。
エラーも山ほど
最初は当然失敗しました。
原因は、
「ファイルが存在しない」
でした。
実はJSONに書いていたのは
sample.wav
test.png
という仮のファイル名。
実際に生成されたファイル名を確認して差し替えると、一気に動き始めました。
AI同士をつなぐ時は、
「モデルが悪い」
より
「ファイルパスが違う」
ことの方が多いですね(笑)
そして完成
最終的にできたのは、
画像
↓
音声
↓
字幕
↓
MP4動画
しかもAndroidでも問題なく再生。
字幕もしっかり表示されました。
ここまで確認できた時は、思わず
「きた!」
となりました。
今のワークフロー
現時点では、
固定テキスト
↓
Irodori TTS
↓
Whisper
↓
ComfyUI
↓
Video API
↓
MP4動画
という流れです。
固定テキストから動画までは、一通り完成しました。
次はいよいよ本命
ここからは、
note記事
↓
Qwen(要約・動画台本)
↓
Irodori
↓
Whisper
↓
ComfyUI
↓
Video API
↓
完成動画
へ進めます。
つまり、
記事を一つ書けば、動画まで自動生成する
そんなAI制作工場に近づいてきました。
振り返ると
数日前までは、
「Linuxってどう使うんだろう」
というところから始まりました。
そこから、
Linux
Docker
Samba
n8n
Ollama
ComfyUI
Irodori TTS
Whisper
FastAPI
FFmpeg
を一つずつ組み合わせながら、ようやくここまでたどり着きました。
正直に言うと、ここまでLinuxを入れ、n8nでComfyUIやIrodori、Whisperと一つずつ繋ぎながらも、心のどこかでずっと不安がありました。
「本当にこれ、全部繋がるのか」
「どこかで致命的なミスをしていて、また最初からやり直しになるんじゃないか」
そんな思いを抱えながら、一つずつ組み上げてきました。
今回、実際に動画として形になったのを見て、
「あ、ちゃんと繋がっていたんだ」
と、初めて少し安心できました。
不安がなくなったわけではありませんが、「積み上げてきたものが無駄じゃなかった」と思えたのは、地味に大きな収穫でした。
まだ完成ではありません。
でも、「点」だったAIツールが、少しずつ「線」になり始めています。
この積み重ねが、きっとあとから大きな差になる。
そんな手応えを感じた一日でした。
ブログサムネイラスト生成
コメント