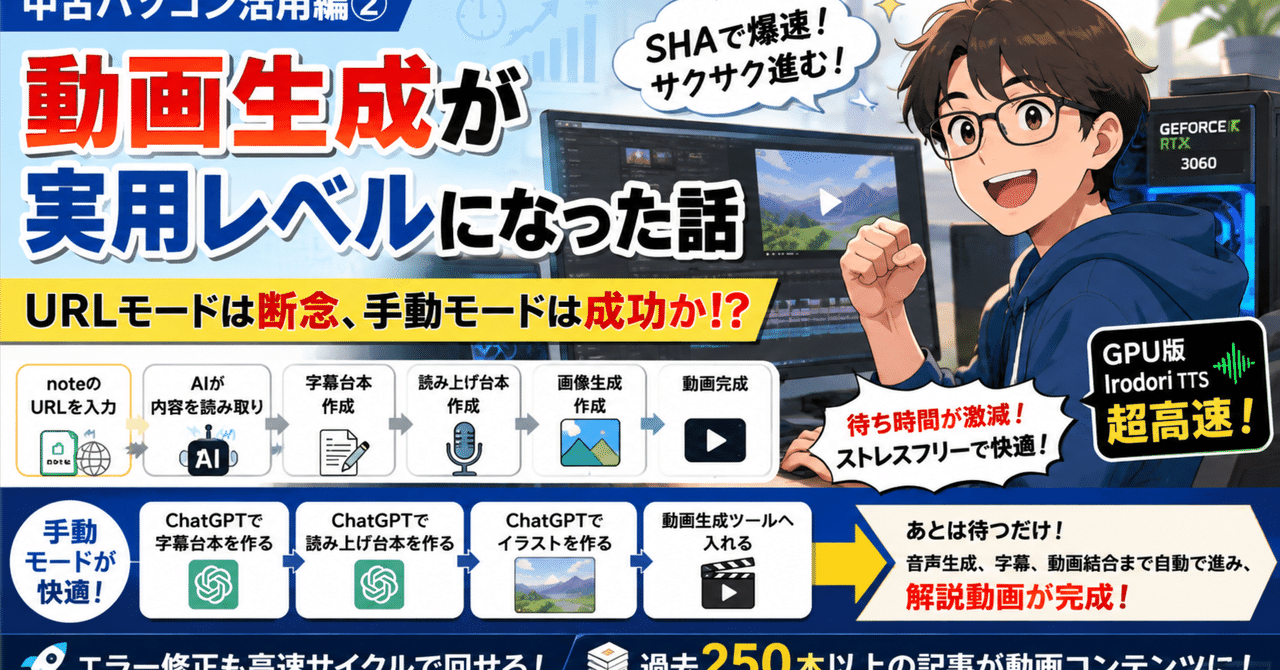
新しいGPUパソコン(SHA)へ環境を移してから、一番変わったのは動画制作のスピードでした。
以前はFMVAで動画生成フローを運用していましたが、今回SHAへ移行したことで、「これなら日常的に使える」と思えるレベルまで快適になりました。
URLモードは一旦断念
当初は、
-
noteの記事URLを入力
-
AIが内容を読み取り
-
字幕台本作成
-
読み上げ台本作成
-
画像生成
-
動画完成
という完全自動を目指していました。
しかし、現時点ではローカルLLM(Bonsai)による文章品質と、ComfyUIによる画像品質が、自分の求める実用レベルには届きませんでした。
「自動では作れる。でも公開したい品質ではない。」
そう判断し、このルートはいったん保留にしました。
手動モードが想像以上に快適だった
代わりに採用したのが手動モードです。
作業はとてもシンプル。
-
ChatGPTで字幕台本を作る
-
ChatGPTで読み上げ台本を作る
-
ChatGPTでイラストを作る
-
それらを動画生成ツールへ入れる
あとは待つだけ。
音声生成、字幕、動画結合まで自動で進み、解説動画が完成します。
この方法なら品質も安定していて、ほとんど迷うことがありません。
RTX 3060とGPU版Irodori TTSがとにかく速い
SHAへ移して一番驚いたのは、GPU版Irodori TTSの速度です。
FMVA時代とは比較にならないくらい高速。
「まだ終わらないかな」と待つ時間がほとんどなくなりました。
音声生成が終われば、そのまま動画生成まで一気に流れていきます。
体感では、「動画を作ろう」と思ってから完成までのストレスが大幅に減りました。
エラー修正も速くなった
動画生成では、どうしても細かなエラーは発生します。
でも、生成が速くなったことで開発サイクルも変わりました。
エラーが出る ↓ Codexへ修正依頼 ↓ 修正 ↓ すぐ再生成 ↓ 結果確認
この1サイクルが短時間で回せるようになったため、「今日はここまでにしよう」が減りました。
試行錯誤の回数を増やせるようになったことは、速度以上に大きなメリットだったと思います。
過去250本以上の記事が動画コンテンツになる
現在は、この手動モードで過去の記事を少しずつ動画化しています。
一から企画を考える必要はありません。
すでに書いた記事を、
-
字幕台本
-
読み上げ
-
イラスト
-
動画
へ変換するだけ。
記事という資産を動画という別の形で再活用できるようになりました。
完璧な自動化より、実用的な半自動化
AIを使っていると、つい「全部自動化」を目指したくなります。
でも実際には、
文章と画像はChatGPTで品質を確保する。
音声生成や動画化など、時間のかかる作業だけをローカルGPUへ任せる。
この役割分担のほうが、現時点では圧倒的に実用的でした。
SHAへの移行で得られたのは、性能だけではありません。
「思いついたら動画にする」という作業が、ようやく日常のルーチンになり始めています。
コメント