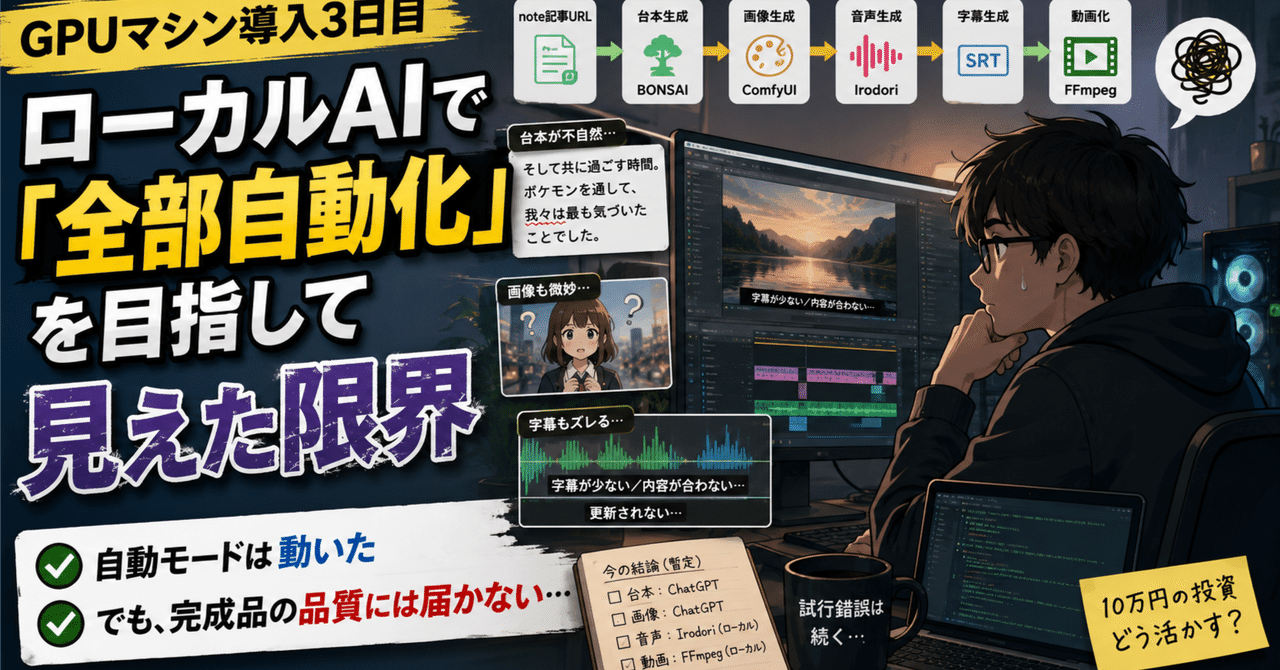
GPU付きの中古パソコンを導入してから、3日目。
ここまで、かなりの勢いで環境構築を進めてきました。
ローカルLLMのBONSAI、画像生成のComfyUI、音声生成のIrodori、動画処理のFFmpeg。さらに、noteの記事URLを入力すると、台本作成から音声、字幕、画像、動画まで自動で作る仕組みも形になってきました。
GPUを積んだ新しいパソコンは、明確に速いです。
処理速度だけを見れば、以前使っていた古いノートパソコンとは比べものになりません。音声生成も画像生成も、ローカルAIを試すこと自体が現実的になりました。
しかし、実際に完成した動画を確認していく中で、別の問題が見えてきました。
自動化はできても、完成品の品質が足りない
今回目指していたのは、単にローカルAIを動かすことではありません。
理想は、
noteの記事URLを入力する
↓
内容を要約して動画台本を作る
↓
音声、字幕、画像を生成する
↓
完成動画が自動で出来上がる
という、一気通貫の自動動画生成です。
仕組みとしては、かなり近いところまで来ました。
ところが、BONSAIが生成した台本を確認すると、日本語として不自然な箇所が残っていました。
たとえば、
そして共に過ごす時間。ポケモンを通して、我々は最も気づいたことでした。
といった文章です。
意味は何となく想像できますが、主語と述語が合っておらず、そのまま公開動画には使えません。
一文だけなら直せます。
しかし、動画を作るたびに台本を最初から最後まで確認し、不自然な表現を一つずつ修正するのであれば、自動化の利点がかなり薄くなります。
それなら最初からChatGPTやClaudeで台本を作り、完成した文章を手動モードへ入力した方が早い。
そう感じ始めました。
BONSAIは速い。しかし、検品が必要になる
BONSAIはローカルで動き、回数制限もありません。
下書きや粗い要約には使える可能性がありますが、その結果にも確認が必要です。
私が求めていたのは「文章らしいもの」ではなく、ほぼそのまま公開できる動画台本でした。
必要なのは、
-
自然な日本語
-
前後の文脈の維持
-
主語と述語の整合
-
音声として聞きやすい文章
-
内容を壊さない要約
です。
この基準になると、現時点ではChatGPTやClaudeとの差を強く感じました。
生成処理そのものが速くても、出力された文章を人間が毎回検品しなければなりません。
数秒で文章が出ても、その後の修正に何分もかかるのであれば、制作全体としては速くありません。
ローカルLLMは「無料で使えるChatGPT」ではなく、管理と確認を前提に使う別の道具なのだと思います。
ComfyUIで感じた利点は、ほぼ「無料」だけだった
画像生成についても、期待していた結果にはなりませんでした。
ComfyUIについては、一般的に「細かな制御ができる」「大量生成に向いている」と説明されることがあります。
しかし、実際に私が使ってみた感想は、かなり違います。
設定項目が多いことと、思いどおりに制御できることは別でした。
モデルやプロンプト、画像サイズ、生成条件を調整しても、人物の顔や手が崩れたり、指定した構図から外れたりします。
複数の画像を生成することはできますが、その中から使える画像を探し、破綻を確認し、必要に応じて再生成しなければなりません。
これでは、画像をたくさん作れるというより、確認しなければならない候補が増えるだけです。
私がComfyUIに感じた明確な利点は、ローカル環境で無料で生成できることでした。
しかし、無料であっても、低品質な画像を毎回確認し、何度も生成し直すのであれば、時間まで含めて本当に得なのかは疑問です。
それなら、ChatGPTやGeminiの無料プランを使い、少ない試行回数で意図に近い画像を作った方がよい。
少なくとも、私の動画素材作成という用途では、ComfyUIを積極的に使い続ける理由は見つけられませんでした。
世間で言われるComfyUIの強みを、私は今回の用途では実感できませんでした。
字幕の問題も発生した
自動動画生成では、台本以外にも問題がありました。
音声に対して字幕が少なすぎる、字幕の内容が音声と合っていない、字幕が更新されない、といった不具合です。
調査を進めると、台本、音声、字幕、動画の生成物が、同じ世代のものにそろっていない可能性が出てきました。
台本だけが更新され、音声や字幕には古い成果物が残っているような状態です。
そこで現在は、
-
台本が変わったら音声を全再生成する
-
音声が変わったら字幕と動画も無効化する
-
古い成果物を再利用しない
-
音声、字幕、画像時間、動画を一つの世代として管理する
-
字幕を最大2行程度に収める
といった修正を進めています。
これは自動モードだけでなく、手動モードを安定させるためにも必要な修正です。
ただし、字幕や処理の不整合が直っても、元の台本が不自然なら、完成するのは「不自然な文章を正確に読み上げた動画」です。
システム上の問題と、生成AI自体の品質問題は、分けて考える必要があります。
結局、手動モードの方が実用的かもしれない
ここまで試した結果、現在の私に合っている構成は、かなりシンプルです。
ChatGPTやClaudeで台本を作る
↓
ChatGPTで画像を作る
↓
完成した台本と画像を手動モードへ入れる
↓
Irodoriで音声を生成する
↓
字幕と動画を自動生成する
これなら、内容の品質を決める部分は高性能なクラウドAIへ任せられます。
その後の繰り返し処理は、ローカルパソコンで自動化できます。
台本と画像を自分で用意するため、完全自動ではありません。
しかし、生成物を一つずつ確認して修正するより、最初から品質の高い素材を投入した方が、結果的には楽です。
自動モードは完成品を作る機能というより、
noteの記事から、動画の試作品を自動で作る機能
くらいに考えた方がよいのかもしれません。
IrodoriとFFmpegは、かなり良い
一方で、今回試したすべてが期待外れだったわけではありません。
Irodoriの音声生成は、十分に実用性を感じています。
入力する文章が決まっていれば、ローカルで何度でも音声を生成できます。外部APIの料金を気にせず、修正や再生成を繰り返せる点も大きな利点です。
FFmpegも非常に優秀です。
音声、字幕、画像を組み合わせ、動画として書き出す処理は安定しています。
画像や台本の内容を考える必要はありませんが、入力された素材を決められた形へ変換する処理には強い。
このような、
判断や表現ではなく、決められた処理を高速で繰り返す仕事
は、ローカル環境と非常に相性が良いと感じました。
GPUマシンは必要だったのか
正直に言えば、少し複雑な気持ちもあります。
今回の最終構成が、
-
台本はChatGPT
-
画像もChatGPT
-
ローカルでは音声と動画を生成
という形になるのであれば、以前のパソコンでも時間をかければ実行できた可能性があります。
GPUマシンによって処理は明確に速くなりました。
しかし、「GPUマシンを買ったことで初めて可能になった」というより、
以前からできたことが、かなり快適になった
という方が近いかもしれません。
購入時には、BONSAIとComfyUIを使い、文章も画像もローカルで作る制作工房を期待していました。
その中心部分をクラウドAIへ戻すのであれば、少し残念ではあります。
ただし、GPUマシンが無駄だったとも言い切れません。
実際にローカルモデルを高速で動かし、自分の用途に使えるかを試したからこそ、限界を短期間で確認できました。
古いパソコンでは処理が遅すぎて、ここまで試す前に諦めていた可能性もあります。
とはいえ、それだけで10万円の投資に納得できるかというと、今はまだ答えが出ません。
ローカルAIの使い道を、まだ見つけ切れていない
今回の経験で、ローカルAIに対する見方は変わりました。
少なくとも現時点では、ChatGPTやClaudeをそのまま置き換えられるものではありませんでした。
回数制限を気にせず試せることや、外部サービスに依存せず動かせることには利点があります。
思いついた仕組みを自分の環境へ組み込み、動作を検証する実験設備として使える場面もあると思います。
ただ、それが10万円をかけて導入したGPUマシンの十分な使い道なのかと問われると、今はまだ分かりません。
Irodoriによる音声生成や、FFmpegによる動画処理は実用的でした。字幕生成や大容量データの保存、各種の自動化にも使えます。
しかし、これらは以前のFMVAでも、時間をかければできていたことです。
新しい環境だからこそできることを、私はまだ見つけ切れていません。
3日目の結論
3日目までに、noteの記事URLから動画を作る自動処理は、技術的にはかなり形になりました。
しかし、実用性という点では、まだ課題が残っています。
現時点での正直な評価は、
自動モードは動いた。
ただし、日常的に使える完成品の品質には届いていない。
です。
そして、ローカルAIで何でも置き換えればよいわけではないことも分かりました。
文章や画像のように、文脈理解や表現力が重要な部分はクラウドAI。
音声生成、字幕処理、動画化、保存のように、入力が決まっている反復処理はローカル環境。
現時点では、この役割分担が最も現実的なのだと思います。
期待していた完全自動の動画工房には、まだ届きませんでした。
正直に言うと、今はまだこの結論に気持ちが追いついていません。
GPUマシンには10万円かけました。
手動モードだけなら、実は以前のFMVAでも、時間をかければ同じことができていたはずです。
そう考えると、素直に「良い投資でした」とは言い切れない自分がいます。
なんとかしたい、という気持ちはあります。
音声生成や動画化はローカルで無制限に回せるようになりましたし、この環境をもっと活かす道も、まだ探せるはずです。
ただ、今日のところは、その先を考える気力が出てきません。
コメント